비교 질문을 한 숫자로 끝내지 않기
로컬 실험에서 Pod 구성 후보와 메모리 제약을 확인한 뒤, 실제 AWS에서는 EC2 ASG와 EKS MSA를 순차 실행했다. 알고 싶었던 것은 단순한 최고 처리량이 아니었다. 정상 확장 정책에서 어디까지 기준을 지키는지, 부하가 갑자기 오르거나 오래 유지될 때 같은 판단이 성립하는지, 한계를 넘은 뒤 회복하는지까지 비교해야 했다.
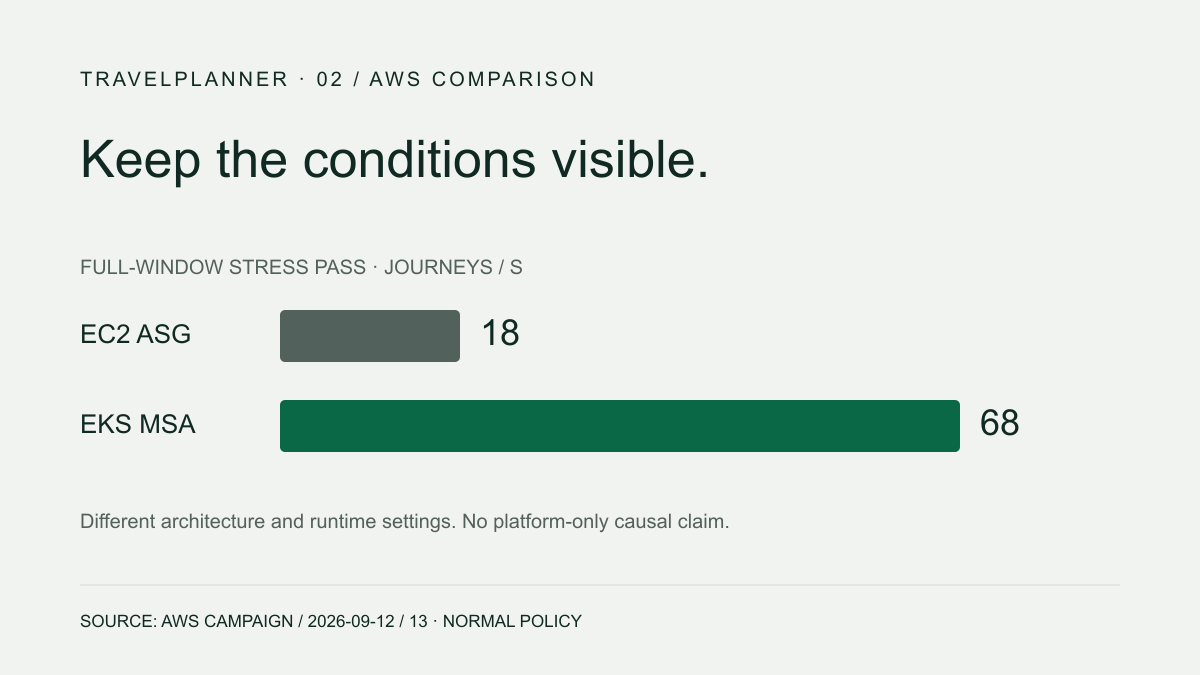
2026년 9월 12~13일 캠페인에서 정상 정책 stress의 전체 구간 통과값은 EC2 18, EKS 68 journeys/s였다. 그러나 이를 “EKS로 성능 3.8배 개선”이라고 표현하지 않는다. 모놀리스와 MSA의 구조, DB 연결 풀, 확장 방식이 함께 다르고 EKS에는 시험 중 런타임 조정도 있었다. 이 글은 해당 조건에서 실제로 관측한 운영 결과를 설명한다.
이전 TravelPlanner 글의 20 rps 기준선은 다른 시점과 부하 모델의 결과다. 이번 단위는 사용자 작업 흐름을 시작하는 journeys/s다. 하나의 journey에서 여러 API를 순서대로 호출하므로 과거 API ops/s와 직접 비교하거나 같은 그래프의 연속 측정으로 이어 붙이지 않았다.
같게 둔 것과 같지 않은 것
앱 인스턴스와 EKS 노드는 t3.large, 정상 시작 정책은 min/desired/max 2/2/4였다. 부하 발생기는 c6i.4xlarge였고, 실제 EC2에서 실행한 k6 소스를 EKS 패키지에도 연결했다. 이는 비교할 사용자 행동을 맞추기 위한 조건이다.
EKS 기준 소스는 MSA 전환 커밋 9d0403a였다. 다만 초기 DB 연결 고갈에 대응해 네 서비스의 Hikari minimumIdle을 런타임에서 1로 적용했다. 따라서 브랜치 원본과 완전히 같은 설정으로 시험했다고 쓰지 않는다. maximumPoolSize, HPA, Pod 자원과 함께 실제 readback을 기준으로 해석했다. 9월 14일의 후속 maximumPoolSize 5 변경은 이 시험 뒤의 개선이며 이번 결과의 조건에 소급하지 않는다.
같은 인스턴스 종류를 사용해도 서비스 수, Pod 배치, 프로세스 수와 연결 수는 다를 수 있다. 이번 설계는 플랫폼만 바꾸고 모든 요소를 고정한 인과 실험이 아니다. 전체 시스템의 운영 특성을 비교하고 다음 조정 지점을 찾는 실험으로 범위를 한정했다.
전체 구간 통과와 마지막 안정 구간은 다르다
Baseline은 16 journeys/s를 300초씩 세 번 실행했다. EC2는 세 번 모두 PASS였고 EKS는 첫 번째 BELOW_CRITERIA 뒤 두 번 PASS였다. 첫 회의 지연과 실패를 지우고 “세 번 안정적”이라고 요약하지 않았다.
Stress는 더 높은 부하를 단계적으로 검증하며 전체 측정 구간의 판정과 마지막 안정 tail을 분리했다. EC2의 19는 tail만 기준을 만족했고 전체 PASS는 18이었다. 반면 EKS 68은 전체 구간과 안정 tail을 모두 만족했다.
| 조건 | EC2 ASG | EKS MSA |
|---|---|---|
| Baseline 16, 300초 × 3 | PASS / PASS / PASS | 기준 미달 / PASS / PASS |
| 정상 정책 전체 구간 PASS | 18 journeys/s | 68 journeys/s |
| 정상 정책 상단 관측 | 19는 tail만 안정, 20은 SLO 미달 | 72에서 SLO 미달 |
| 자연 노드·인스턴스 확장 | CPU 정책 조건 미도달로 미관측 | 노드 2→3→4, 업무 요청 확인 |
| 통제된 최대 4대 전체 PASS | 10 journeys/s | 64 journeys/s |
| 최대 4대 상단 관측 | 11에서 SLO 미달 | 68에서 SLO 미달 |
정상 정책 시험과 통제된 최대 네 대 시험은 서로 다른 구성 결과다. 원하는 최대 대수로 미리 맞춘 뒤의 결과를 자연 scale-out의 증거로 사용하지 않았다. EKS에서는 seed 도중 이미 늘었던 세 번째 노드도 부하 시험의 자연 확장으로 계산하지 않았다.
EC2의 최대 네 대 결과가 정상 정책보다 낮다는 점도 숨기지 않았다. 서버가 늘면 각 프로세스의 DB 연결과 경쟁도 바뀔 수 있다. 이 캠페인에서는 RDS 포화를 관측했지만 특정 SQL 하나를 원인으로 확정하지 않았다. 기존 프로젝트의 일정 정렬 SQL 개선 사례와 이 결과를 근거 없이 같은 원인으로 묶지 않았다.
dropped iteration을 서비스 한계로 부르기 전에
EKS 최초 96 journeys/s 실행에서는 dropped iteration 699개가 나왔다. 이 값만으로 애플리케이션 처리 한계를 확정할 수 없었다. Arrival-rate 부하는 응답이 늦어지면 진행 중 VU가 오래 점유되고, 발생기에서 준비한 VU를 소진하면 예정된 반복을 시작하지 못한다. 서비스 지연과 부하 공급 한계가 함께 나타날 수 있다.
VU를 8,192로 보강한 뒤 같은 96 부하에서 drop 0을 확인했지만 SLO 미달은 계속됐다. 앞선 runner 제한은 보존하고, 도구가 정상적으로 부하를 공급한 뒤에도 남는 미달을 별도 근거로 삼았다. 8,192는 준비한 executor 자원이지 동시에 서비스를 사용한 검증된 사용자 수가 아니다.
인증 도구 오류도 같은 방식으로 취급했다. 계정 상태나 refresh 처리 실패가 있으면 서비스 전체 용량 판정에 그대로 넣지 않고 도구 수리·계정 복구 후 회복을 검증했다. 실패 실행을 삭제해 깨끗한 표만 만들지 않은 이유는 이후 결과가 어떤 수리를 전제로 하는지 알아야 하기 때문이다.
Spike의 peak가 성공해도 전체가 성공은 아니다
절대 spike는 두 환경 모두 16→32 journeys/s로 비교했다. EKS의 peak에서는 3,841건이 모두 성공했지만 전체 실행 판정은 BELOW_CRITERIA였다. Peak의 성공과 전환·회복을 포함한 전체 판정은 서로 다른 주장이다. 회복 마지막 180초 PASS도 전체 실행의 미달을 덮지 않는다.
상대 spike는 각 트랙에서 선택한 S를 두 배로 높였다. EC2는 19→38, EKS는 68→136이었다. EC2의 S=19가 전체 stress PASS 18과 다르므로 상대 spike가 “전체 통과 부하의 정확히 두 배”였다고 쓰면 안 된다. 원래 실행한 조건을 그대로 표시했다.
EKS 상대 spike peak는 16,321건 완료 중 3,503건 성공, 12,818건 실패였으며 drop/tool은 0이었다. 서비스가 부하를 받았지만 많은 journey가 실패했다는 결과다. 이후 600초에 180초를 더 관측해 마지막 안정 구간을 확인했다. 이렇게 과부하와 회복을 함께 남겨야 높은 stress 통과값이 급격한 수요 증가에도 그대로 적용된다는 오해를 줄일 수 있다.
한 시간 중 한 번의 미달도 남겼다
| Soak 조건 | EC2 ASG | EKS MSA |
|---|---|---|
| 절대 16 journeys/s, 1시간 | 60개 창 중 59개 PASS, 전체 기준 미달 | 60개 창 중 59개 PASS, 전체 기준 미달 |
| 상대 floor(0.7S), 1시간 | 13 journeys/s, PASS | 47 journeys/s, 1건 실패로 기준 미달 |
EKS 절대 soak는 완료 57,601건, 성공 57,600건, 실패 1건이었다. 상대 soak는 완료 169,201건, 성공 169,200건, 실패 1건이었다. 두 실행 모두 drop/tool은 0이고 60개 판정창 중 59개가 PASS였다. 대부분의 요청이 성공했다는 관찰과 정의된 전체 기준을 통과하지 못했다는 판정을 동시에 유지했다.
이 결과를 장기 운영 가용성 수치로 환산하지 않았다. 한 시간의 특정 조건에서 측정한 결과이며 드문 장애의 분포나 장기간 메모리 변화를 충분히 대표하지 않는다. 전체 평균만 보면 작은 실패창이 가려질 수 있어 구간별 판정이 필요했다.
비교 결과가 바꾼 판단
첫째, EKS의 높은 정상 정책 통과 부하만으로 도입 효과를 설명하기보다 신규 노드에서 실제 업무 요청까지 이어졌는지를 별도로 확인해야 했다. 둘째, 최대 대수를 늘리는 것과 DB 병목을 푸는 것은 다른 문제였다. 셋째, stress에서 찾은 부하를 spike와 soak의 보장값으로 사용하면 안 됐다. 세 실험이 검증하는 조건이 다르기 때문이다.
실행 완료 역시 전부 PASS라는 뜻은 아니다. 이 캠페인은 SLO 미달, runner 제한, 인증 도구 수리, 회복 결과를 보존한 상태로 요청된 시험과 증거 회수·정리를 끝냈다. 원격 일반 파일은 EC2 96,816개, EKS 56,430개를 로컬 원본과 대조했고 처음 누락된 파일은 별도로 회수해 최종 누락을 해소했다. 시험 환경 정리는 9월 13일 확인 기록이며 현재 AWS 상태를 새로 조회한 결과는 아니다.
다음 글에서는 확장과 장애에서 “노드가 생겼다”, “Pod가 Ready다”, “업무가 정상이다”를 어떻게 구분했는지 다룬다. 비교표의 숫자 뒤에서 실제 운영 판단을 바꾼 부분이다.
근거
비교 수치는 9월 12~13일 SCRUM-77-COMPARISON.partial.md, MATRIX.partial.json, EKS RESULTS.md를 대조했다. 원본 파일명에는 partial이 남아 있지만 최종 본문과 판정 상태는 완료다. 공개용 JSON은 수치와 조건을 추출한 자료이고 private 원본 로그 전체가 아니다.