인스턴스를 고르기 전에 확인할 것
EKS에 MSA를 올리려면 먼저 각 서비스의 Pod 수, CPU와 메모리 request, HPA 기준을 정해야 했다. 모든 서비스를 두 개씩 배치하면 단순하지만, 그 구성이 필요한지 설명하기 어렵다. 반대로 로컬에서 한 번 실행됐다는 이유로 작은 노드를 선택하면 배포 중 겹치는 Pod와 장애 여유를 놓치게 된다.
2026년 9월 8일의 로컬 실험에서는 이 결정을 세 질문으로 나눴다. 기본 혼합 부하에서 줄일 수 있는 Pod가 있는가, 느린 의존성이 생겨도 같은 판단이 유지되는가, 그렇게 정한 자원 예약이 노드 예산에 들어가는가. 목표는 AWS 성능을 예측하는 공식이 아니라 실제 배포에서 검증할 후보를 만드는 것이었다.
Docker Desktop에 12GiB를 배정하고 엔진 가용량 11.67GiB를 확인한 뒤 ARM64 kind 환경에서 실행했다. 총 32회 k6 실행에서 HTTP 1,211,566건을 수집했다. 판정은 LOCAL_PASS 19회, FAILED 5회, INCOMPLETE 8회였다. 마지막 항목은 짧은 smoke 7회와 fixture 진단을 위한 중단 1회다. 서로 다른 목적의 실행을 모은 숫자이므로 19/32를 서비스 신뢰도나 가용성으로 바꾸지 않았다.
같은 부하에서 Pod 하나씩 줄여 보기
서비스 순서는 identity, travel, community, maps다. A는 모두 두 개, C는 identity만 한 개, B는 identity와 maps를 한 개로 줄였다. 각 구성은 새 클러스터에서 시작했고, 기본 실험의 앱 이미지 ID를 동일하게 유지했다.
혼합 journey는 travel 조회 40%, 편집 20%, maps 20%, community 15%, session 5%다. 하나의 journey 안에서는 관련 API를 순차 호출하고 응답 계약을 검사했다. 따라서 journeys/s는 HTTP requests/s와 다른 단위다. 사용자는 256명을 미리 준비하고 VU별 계정을 분리해 실제 refresh와 토큰 회전을 사용했다. 256은 fixture와 executor의 설정이며 동시 사용자 수를 검증한 결과가 아니다.
Stress는 1, 4, 16, 32, 64 journeys/s를 각 300초 유지했다. 단계 전환은 30초였다. Spike는 1에서 32로 1초 만에 올려 180초 유지하고, 별도 회복 구간도 관측했다.
| 구성 | Pod 수 | 64 구간 HTTP p95 | Stress 판정 |
|---|---|---|---|
| A | 2 / 2 / 2 / 2 | 36.56ms | PASS, 오류 0 |
| C | 1 / 2 / 2 / 2 | 35.92ms | PASS, 오류 0 |
| B | 1 / 2 / 2 / 1 | 35.81ms | FAILED, maps 오류 1건 |
| HPA | 각 1개에서 시작 | 37.20ms | PASS, 오류 0 |
모든 기본 stress의 dropped iteration은 0이었다. B의 평균적인 지연은 좋아 보였지만 maps 검색에서 502와 계약 오류 한 건이 있어 실패로 남겼다. 그 한 건의 정확한 transport 원인은 확정하지 못했다. CPU 포화나 나중에 발견한 mock 결함을 원인으로 소급 적용하지 않았다.
A와 C가 도달한 64는 시험의 마지막 단계다. 그 이상에서 실패할 때까지 찾은 값이 아니므로 최대 처리량으로 표현하지 않았다. identity 단독 burst에서도 6,513 session journey와 HTTP 13,026건을 오류·drop 없이 처리했다. 이는 성능 관점에서 identity 한 개를 후보로 둘 근거지만, 한 Pod 장애 때의 가용성을 입증하지 않는다.
HPA가 늘었다는 사실과 제때 도움이 됐다는 판단
HPA는 서비스별 1~2개, CPU ContainerResource 목표 60%로 별도 실행했다. Stress에서 travel은 16 단계, maps는 32 단계, identity는 64 단계 후반에 실제로 두 개가 됐다. community는 한 개를 유지했다. community 두 개가 이 부하를 처리하는 데 반드시 필요했다는 근거는 없고, 두 개 유지는 배포·가용성 여유를 고려한 보수적 후보였다.
Spike에서는 travel의 Ready Pod가 1→2→1로 변했다. 전체 peak SLO는 통과했지만 시작 부근 5초 구간의 HTTP p95는 약 870ms까지 올랐다. 확장 기능이 동작한다는 사실만으로 순간 지연까지 해결했다고 말할 수 없었다.
추가 Pod가 생성된 뒤 Ready까지는 약 15~16초였다. 그러나 travel이 정의된 안정 응답 조건을 만족한 관측 시각은 약 263초였다. 안정 조건은 rolling 지연, 60초 안정창, 최소 요청 20개를 함께 본 것이다. 263초 동안 아무 요청도 처리하지 못했다는 뜻은 아니다. 표본이 부족하면 p95를 만들어 넣지 않고 미관측으로 남겼다.
CPU request 250m에서 목표 60%는 명목상 150m다. 이 숫자만 낮추는 대신 수요 증가, metrics 수집, HPA 판단, 기동 CPU, 실제 업무 응답까지 함께 볼 필요가 있었다. CPU 60%는 빠른 의존성 조건의 다음 검증 후보로 남겼고 최적값으로 확정하지 않았다.
maps를 두 개로 늘려도 travel이 기다렸다
기본 부하만으로는 의존성이 느려질 때를 설명할 수 없었다. 최종 비교에서는 외부 API mock을 300ms 지연으로 고정하고 인위적인 오류와 tail을 제거했다. maps journey 16회/초를 900초 실행하며 B와 C를 비교했다. 일부 cache key를 약 5초마다 삭제했지만 이 동작을 내부 location API의 cache 적중률로 해석하지 않았다.
| 측정값 | maps 1개 | maps 2개 |
|---|---|---|
| HTTP 오류 | 4,211건 / 6.92% | 989건 / 1.46% |
| 성공 journey | 6,171 | 9,024 |
| Dropped iterations | 4,019 | 4,388 |
| travel HTTP p95 | 15,001ms | 14,326ms |
| travel Pod별 Hikari active / 최대 | 10 / 10 | 10 / 10 |
| travel Pod별 pending 최대 | 190 | 190 |
| 최종 판정 | FAILED | FAILED |
maps 두 개에서는 오류가 줄고 성공 journey가 늘었다. 하지만 drop은 늘었고 두 조건 모두 SLO를 만족하지 못했다. 한 방향의 단일 비교이므로 순서 효과나 JIT 영향을 완전히 분리한 인과 실험도 아니다.
더 중요한 단서는 travel 연결 풀이 가득 차 있는 반면 maps의 Hikari pending은 0이었다는 점이다. DB lock wait와 deadlock은 관측되지 않았지만 PostgreSQL snapshot에는 idle-in-transaction/ClientRead 연결 20개가 있었다. 소스에서는 travel의 조회 트랜잭션 안에서 동기 Maps 호출을 수행했다. 외부 응답을 기다리는 동안 DB 연결을 점유하는 구조가 pool 대기에 기여한다는 근거가 연결됐다. 개별 요청의 시간 분해는 tracing이 더 필요했다.
이 때문에 다음 개선 후보는 외부 I/O와 DB 트랜잭션 범위 분리, 내부 location cache 경로 확인, timeout과 동시성 제한 검토였다. 이번 로컬 실험에서 그 앱 코드를 수정해 해결했다고 주장하지 않는다. Pool이나 CPU를 늘리기 전에 대기 원인을 확인할 필요가 있다는 결론이다.
처음 사용한 느린 mock에는 TCP backlog overflow 문제가 있었다. 그 실행을 진단용으로 중단했고, mock 전환 시 이전 프로세스 종료가 겹친 재시도도 별도 실패로 보존했다. 최종 B/C 비교는 이전 mock 종료를 확인한 뒤 실행했으며 TCP overflow/drop 증가가 0이었다. 부하 도구 자체의 실패를 서비스 한계에 섞지 않기 위한 정리였다.
메모리 예산에는 교체 중인 Pod도 들어간다
관측된 container working set 최대는 identity 494.9MiB, travel 788.9MiB, community 951.8MiB, maps 442.3MiB였다. travel과 community의 memory request를 높여 유지할 이유가 있었고, community는 1GiB limit까지 여유가 약 72MiB에 불과했다. 최대 관측값을 안전한 상한으로 확정할 수는 없다.
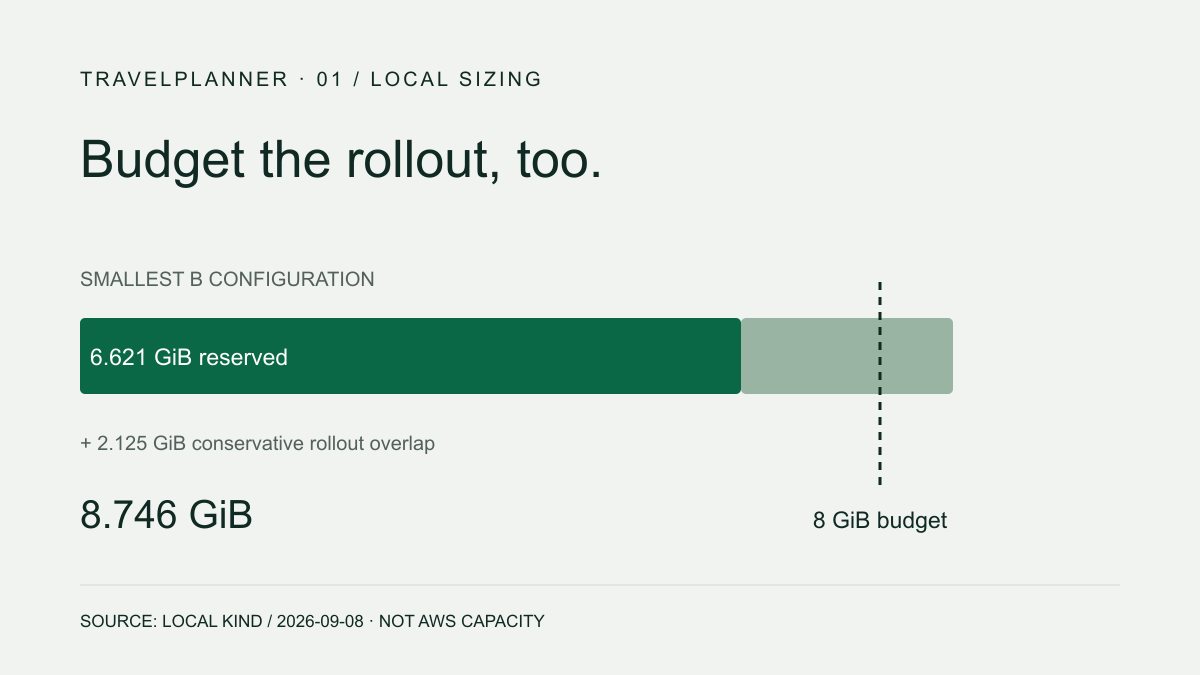
렌더링한 EKS 매니페스트에서 앱·sidecar·명시된 platform requests를 합산했다. A는 7.746GiB, C는 7.184GiB, 가장 작은 B도 6.621GiB였다. 보수적으로 단일 서비스 교체 중 종료 Pod까지 겹치는 2.125GiB를 더하면 B는 8.746GiB가 된다. 노드 두 대에 가정한 물리 메모리 합 8GiB를 이미 넘는다. OS, 관리 addon, allocatable, 노드별 배치, 동시 rollout 여유는 이 계산에 아직 포함되지 않았다.
따라서 t3.medium 두 대로 축소할 근거가 부족했다. 이것은 B가 idle 상태에서 절대 배치되지 못한다는 증명이 아니라 배포와 여유를 포함한 축소 승인 조건을 충족하지 못했다는 판단이다. ARM64 로컬 CPU 처리량을 AWS T3 지속 성능으로 환산하지도 않았다.
최종 후보는 C인 1/2/2/2다. 느린 의존성 SLO는 C도 실패했으므로 운영 적합 판정은 아니다. 조건별 한 번의 비교였고 1시간 soak, 노드 장애, 장시간 JVM 메모리, AWS CPU credit까지 검증한 실험도 아니다. 로컬 호스트의 swap도 관측돼 충분한 호스트 여유가 있었다고 말할 수 없다. 이 한계를 남긴 채 다음 단계인 AWS 실측으로 넘어갔다.
근거와 다음 글
수치는 2026년 9월 8일 local-msa-next-round-20260908-r2/REPORT.md 및 자원 예산·판정 JSON에서 옮겼다. 공개용 자료에는 자격증명과 인프라 식별자를 포함하지 않는다. 원본 위치와 해시를 기록한 출처 목록으로 파생 자료의 범위를 확인할 수 있다.