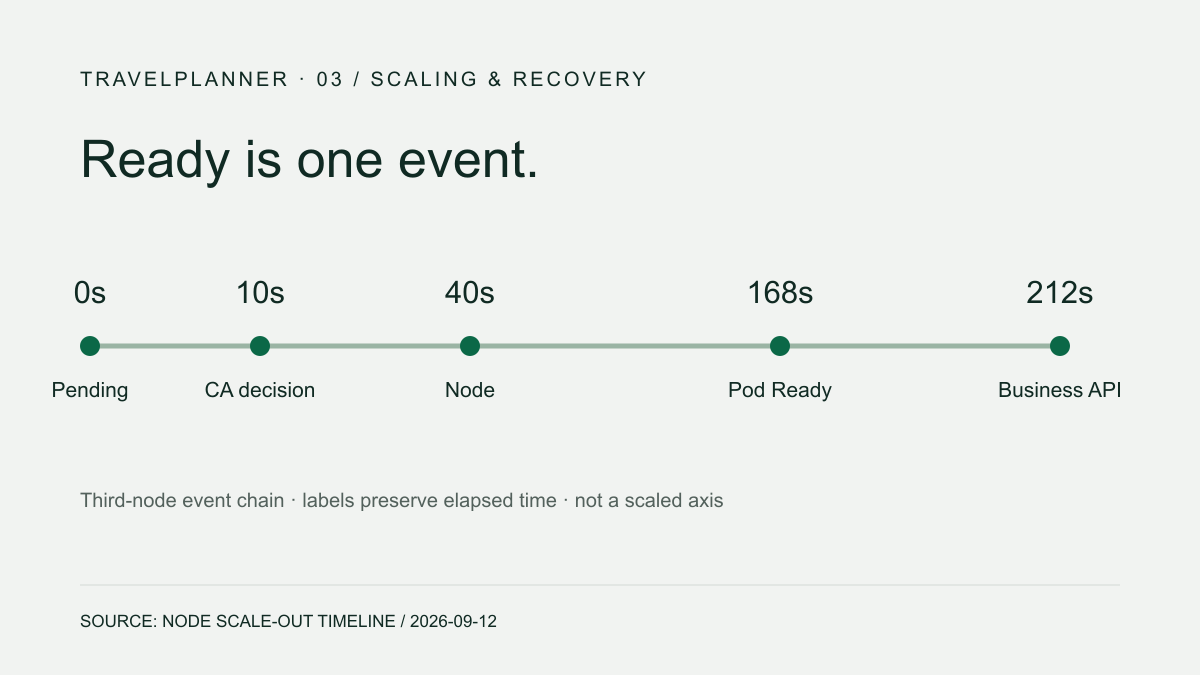
확장은 어느 순간 완료되는가
EKS 비교 실험에서 노드 수가 2→3→4로 늘었다. 하지만 이 숫자만으로 확장이 사용자 요청 처리에 기여했다고 결론내릴 수는 없었다. 새 노드가 등록돼도 앱이 뜨지 않을 수 있고, Pod가 Ready여도 실제 업무 요청의 성공까지 시간이 더 걸릴 수 있기 때문이다.
2026년 9월 12~13일 실험에서는 스케줄 실패, Cluster Autoscaler의 용량 변경, 노드 등록, Pod Ready, 정상 업무 API를 하나의 시간 흐름으로 연결했다. 부하 발생기의 지연만 보거나 Kubernetes 객체 상태만 보는 대신 두 관측을 맞췄다. 이 글의 시간은 그 캠페인에서 관측한 사례이며 EKS의 일반적인 복구 시간이나 보장값이 아니다.
세 번째 노드: 등록 40초, 업무 처리 212초
세 번째 노드가 필요해진 시작점은 travel Pod 두 개의 CPU 부족 스케줄 실패였다. 10초 뒤 Cluster Autoscaler가 desired capacity를 2에서 3으로 늘렸고, ASG 인스턴스 기동은 23초, 노드 등록은 40초 시점이었다.
| 이벤트 | 스케줄 실패 이후 | 확인하는 의미 |
|---|---|---|
| 스케줄 실패 | 0초 | 기존 노드에서 자원 부족 |
| Cluster Autoscaler 용량 변경 | 10초 | 노드 확장 결정 |
| ASG 기동 시작 | 23초 | 컴퓨트 생성 시작 |
| 노드 객체 등록 | 40초 | 클러스터에서 노드 관측 |
| 첫 travel Pod Ready | 168초 | 앱 준비 상태 확인 |
| 첫 정상 업무 요청 | 212초 | 실제 서비스 처리 확인 |
확장 결정부터 노드 등록까지는 30초였지만 첫 업무 요청까지는 스케줄 실패 이후 3분 32초가 걸렸다. 나머지 시간에는 JVM 앱 기동, 프로브, ALB 등록 등이 포함된다. 각 요소의 시간을 개별 tracing으로 완전히 분해한 것은 아니므로 특정 하나가 모든 지연을 만들었다고 단정하지 않았다.
이 결과는 부하가 급격히 오를 때 노드 생성 속도만으로 대응 시간을 산정하면 부족하다는 근거다. HPA가 필요한 Pod를 만들고 Cluster Autoscaler가 자리를 마련한 다음에도 앱의 준비와 연결 경로가 정상이어야 한다. 최소 replica와 배포 여유는 이 전체 시간을 고려해 판단해야 했다.
네 번째 노드: 빠른 인프라, 반복되는 앱 기동
네 번째 노드는 community 스케줄 실패 10초 뒤에 확장이 결정됐고 39초에 등록됐다. 하지만 그 노드의 첫 Pod Ready는 21분 23초 시점이었다. 노드 자체는 빠르게 준비됐지만 높은 stress 부하에서 앱의 기동 실패와 재시도가 반복됐다.
이를 “EKS 노드 생성에 21분 걸렸다”고 표현하면 병목의 위치가 바뀐다. 반대로 “노드가 29초 만에 늘었으므로 자동 확장이 빨랐다”고만 쓰면 실제 서비스 준비 실패를 숨긴다. 노드 등록과 앱 Ready는 서로 다른 이벤트로 기록해야 했다.
새 노드의 업무 API 처리도 함께 확인해 확장 선언과 실제 효과를 구분했다. 다만 새 Pod가 존재했다는 사실을 전체 부하가 정상으로 돌아왔다는 뜻으로 사용하지 않았다. 일부 높은 부하 구간에서는 Pod unavailable과 SLO 미달이 남았다. 앞선 글의 정상 정책 통과 68과 상단 72 미달, 더 높은 부하의 실패를 함께 읽어야 한다.
앱 삭제 실험에서는 측정 도구도 복구 대상이었다
앱 장애는 실제 Pod를 한 번 삭제한 실행을 기준으로 했다. 그 전에 kubectl 출력 옵션 오류로 장애가 주입되지 않은 실행이 있었고, 그것은 실제 장애 증거로 사용하지 않았다. 주입 명령을 시도했다는 기록과 대상 상태가 변했다는 기록은 다르다.
실제 삭제 후 대체 Pod는 47초 뒤 Ready가 됐다. 그러나 해당 측정은 완료 9,601건 중 성공 9,100건, 실패 501건에 인증 도구 오류 81건이 섞여 NEEDS_REPAIR로 남았다. Ready 복귀만으로 서비스 회복 PASS를 선언하지 않은 이유다.
영향을 받은 계정 182개를 복구한 뒤 600초 회복을 다시 실행했고, 그 구간은 9,601건 모두 성공했다. 이 결과는 수리 뒤 회복을 확인했다는 뜻이다. 원래 장애 구간을 성공으로 바꾸거나 도구 오류를 애플리케이션 자체의 처리 한계로 확정하지 않았다. 사용자 계정과 refresh 상태가 있는 실험에서는 부하 도구의 상태도 판정 조건이 된다.
컴퓨트 교체가 끝나도 전체 회복창은 실패할 수 있다
Compute 장애에서는 실제 인스턴스 한 대를 종료하고 대체 노드 Ready와 12개 업무 API의 200 응답을 확인했다. 클러스터가 컴퓨트를 복원하고 기본 기능을 처리한다는 연결은 확보됐다.
하지만 장애 구간의 완료 9,600건 중 성공은 9,372건, 실패는 228건이었다. Drop과 tool error는 0이어서 정상 부하 공급 하에서 서비스 기준을 만족하지 못한 구간으로 남겼다. 이어진 600초 회복에서도 실패 한 건이 있어 전체 BELOW_CRITERIA였고, 마지막 480초는 PASS였다.
전체 회복창과 마지막 안정창을 분리한 것은 단순히 엄격한 표현을 쓰기 위해서가 아니다. 다음 실험에서 회복 조건을 비교하려면 실패가 어느 시점까지 있었고 얼마나 오래 안정됐는지 보존해야 한다. “복구 성공” 한 줄로 줄이면 기능 복원과 SLO 회복이 같은 시각이었다는 오해가 생긴다.
| 주입 | 원래 구간 | 후속 회복 |
|---|---|---|
| 앱 Pod 삭제 | 실패 501건, tool 81건, NEEDS_REPAIR | 영향 계정 복구 후 600초 전체 성공 |
| 인스턴스 종료 | 실패 228건, drop/tool 0, 기준 미달 | 600초 중 1건 실패, 마지막 480초 PASS |
| 실패 이미지 배포 | 600초 9,600건 전체 성공 | 정상 이미지 복원 뒤 600초 9,600건 전체 성공 |
실패 이미지 배포가 통과한 범위
Deployment 장애는 실제로 실패 이미지를 한 번 적용하고 unavailable Pod 하나가 생긴 것을 확인한 뒤 정상 이미지로 되돌리는 방식이었다. 장애와 회복 구간은 각각 600초, 9,600건 모두 성공했고 drop/tool은 0이었다.
중요한 조건은 rolling update의 maxSurge 1, maxUnavailable 0에서 기존 정상 Pod가 계속 서비스했다는 점이다. 새 실패 Pod는 Ready가 되지 못했고 정상 이미지 복원 후 제거됐다. 따라서 이 결과는 잘못된 이미지가 새 Pod에서 실패했을 때 기존 Pod가 서비스를 유지한 사례다. 전체 서비스 중단 뒤 무손실 복구를 입증한 시험은 아니다.
장애 시나리오마다 성공의 의미가 다르다는 사실도 남겼다. 앱 삭제는 replica 교체와 계정 상태, 인스턴스 종료는 노드와 스케줄링, 실패 이미지는 배포 중 기존 Pod 유지라는 경로를 검증했다. 하나의 종합 가용성 점수로 합치면 어느 보호 장치가 작동했는지 설명하기 어려워진다.
후속 개선: DB 연결과 GitOps 적용 범위
부하 시험 시점의 Hikari minimumIdle 1 적용과 9월 14일 후속 코드 변경은 구분해야 한다. 이후 새 Pod의 Flyway 초기화가 DB 연결 슬롯 부족으로 실패하는 상황을 배경으로 네 서비스에 maximumPoolSize 5와 minimumIdle 1을 명시했다. Community 변경은 PR #25, 나머지 세 서비스는 PR #26으로 남아 있다.
이 변경은 Pod 수가 늘어날 때 연결 예산도 함께 늘어난다는 운영 문제에 대응한 것이다. 큰 pool이 언제나 유리한 것은 아니며, steady traffic에 필요한 연결뿐 아니라 배포 중 겹치는 프로세스와 초기화 연결까지 함께 봐야 한다. 다만 이 설정으로 9월 12~13일 전체 캠페인을 다시 통과했다고 주장하지 않는다. 설정 변경과 그 조건의 재검증은 별개의 근거가 필요하다.
GitOps 관련 개인 작업은 Argo CD 적용 준비, 환경값 연결, workload 자동 동기화에 해당하는 PR #21, #22, #23으로 범위를 한정한다. 팀원이 만든 최초 Applications 구성이나 이미지 업데이트 PR 자동화 전체를 내 구현으로 귀속하지 않는다. MSA 전환은 protove 작성 커밋을 근거로 삼고, 다른 사람이 작성한 연결 PR 자체를 내 PR이라고 표현하지 않는다.
실험 종료에 증거 회수와 정리가 포함되는 이유
실행 결과를 이해하려면 원본이 남아 있어야 한다. EKS 일반 파일 56,430개는 로컬 내용 대조를 거쳤고 초기 누락분을 별도 회수해 최종 누락 0을 확인했다. 수집 완료라는 기록 자체가 빈 시계열을 정상값으로 바꾸지는 않는다. 계측 누락과 실제 0을 구분하는 규칙은 그대로 유지했다.
환경 정리는 Ingress와 ALB, support, EKS runtime 순서로 진행했고 9월 13일에는 runtime state 관리 자원 0과 정리 후 plan 변경 없음을 확인했다. 보호 대상 dev state는 유지했다. 이는 해당 시점의 완료 기록이며 지금 AWS가 비어 있다는 실시간 주장과는 다르다. 공개 자료에는 private 로그나 자격증명, 노드 주소와 인스턴스 ID를 복사하지 않는다.
이번 실험이 남긴 판단은 확장과 복구를 업무 응답까지 연결해야 한다는 것이다. 다음 검증에서는 기동 중 DB 연결 경쟁을 줄인 설정을 고정하고 같은 장애·회복 조건을 다시 실행해야 한다. 로컬의 Ready와 안정 응답 차이, AWS의 노드 등록과 업무 처리 차이를 각각 보존해야 개선 전후를 비교할 수 있다.