오래 실행할수록 느려진 요청
TravelPlanner의 EC2 ASG 부하 시험에서 실행 후반의 응답 시간이 늘어나는 현상을 봤습니다. CPU가 부족한지, PostgreSQL이나 Redis가 느려지는지부터 의심할 수 있었습니다. 하지만 요청이 시간이 지나도 같은 일을 하고 있는지 먼저 확인할 필요가 있었습니다.
여행 일정을 만드는 부하 시나리오는 생성에 성공한 타임라인 ID를 가상 사용자 상태에 계속 쌓았습니다. 순서를 바꾸는 요청은 그때까지 쌓인 항목 전체를 역순으로 보냈습니다. 실행 시간이 길어질수록 한 요청이 처리해야 하는 항목 수도 커지는 구조였습니다. 같은 RPS를 유지해도 요청당 작업량은 같지 않았습니다.
그래서 곧바로 서버를 늘리기보다, 로컬 Compose에서 요청의 종류와 항목 수를 분리했습니다. 이 글은 2026년 8월 20일 수행한 진단과 최적화를 9월 21일에 정리한 기록입니다. AWS에서 발견한 질문을 로컬에서 재현하고 코드 변경으로 검증한 과정이며, 아래 수치는 로컬 PostgreSQL·Redis와 합성 데이터에서 측정했습니다.
네 가지 요청으로 원인 후보를 좁혔다
첫 실험은 20 RPS, 3분 준비 부하와 10분 측정으로 구성했습니다. 세 번 반복하면서 variant 실행 순서를 교차해, 항상 나중에 실행한 조건만 불리해지는 효과를 줄였습니다.
| 조건 | 요청 내용 | 확인하려던 질문 |
|---|---|---|
| refresh-only | Refresh Token 회전 | Redis 경로만으로도 후반 지연이 생기는가 |
| read-only | 여행 목록·상세·지도 조회 | PostgreSQL 읽기에서도 같은 패턴이 나타나는가 |
| fixed-cardinality-mixed | 항상 3개 항목의 순서 변경 | 항목 수를 고정해도 지연이 커지는가 |
| growing-cardinality-mixed | 생성한 항목을 누적하고 전체 역순 변경 | 요청당 작업량 증가가 지연과 함께 움직이는가 |
누적 조건의 reorder p95는 마지막 4분위에서 첫 4분위의 3.073배, 3.033배, 3.773배가 됐습니다. 항목 수와 응답 시간의 Spearman 상관계수도 0.996, 0.978, 0.996으로 같은 방향이었습니다. 반면 고정 3개 reorder의 비율은 0.834, 1.134, 0.960이었고, refresh-only와 read-only도 같은 증가 패턴을 보이지 않았습니다.
이 단계의 결론은 항목 수 증가와 DB 왕복 비용을 의심할 근거를 확보했다는 것이었습니다. 상관관계만으로 특정 SQL이 원인이라고 확정할 수는 없었습니다. 한 문장의 실행 시간이 길어지는지, 짧은 문장을 여러 번 부르는지 직접 세어야 했습니다.
느린 SQL 한 문장인가, 늘어난 호출 수인가
두 번째 실험에서는 항목 수를 3, 10, 25, 50, 100, 200으로 고정했습니다. 각각 현재 순서를 유지하는 noop과 전체 순서를 뒤집는 reverse를 실행했습니다. 세 번의 반복과 두 모드, 여섯 항목 수를 조합한 36개 stage가 모두 유효했고 미분류 stage는 없었습니다.
PostgreSQL의 SQL family별 calls와 실행 시간, API 지연, 연결 풀 대기를 함께 봤습니다. noop에서는 timeline UPDATE가 요청당 0회였습니다. reverse에서는 항목 수에 따라 다음처럼 늘어났습니다.
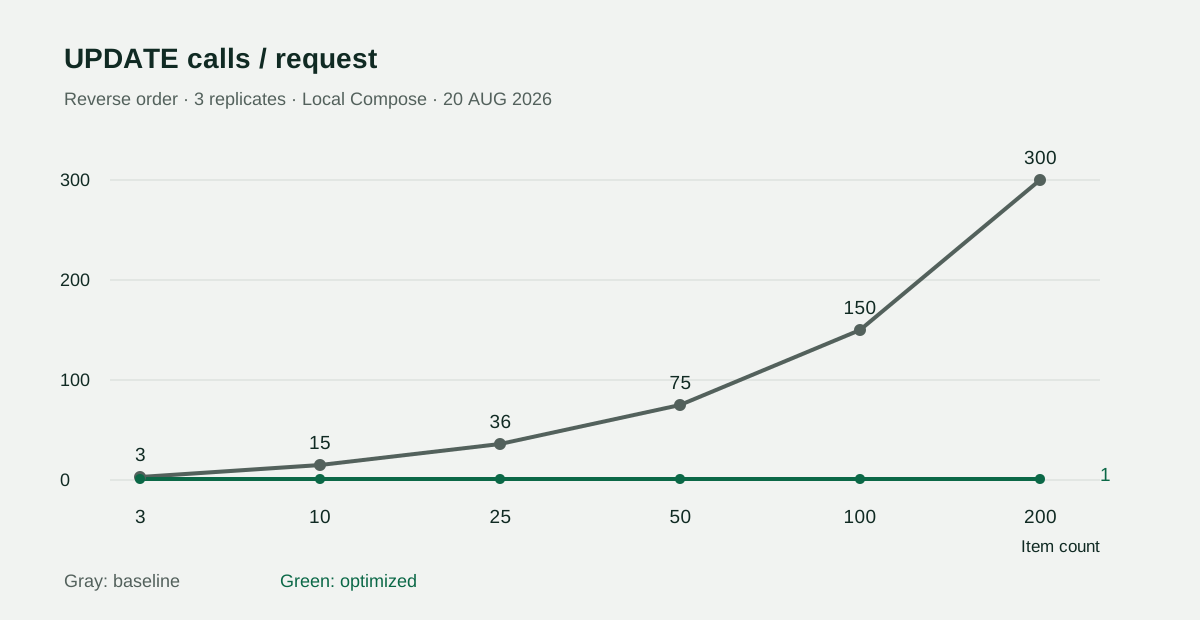
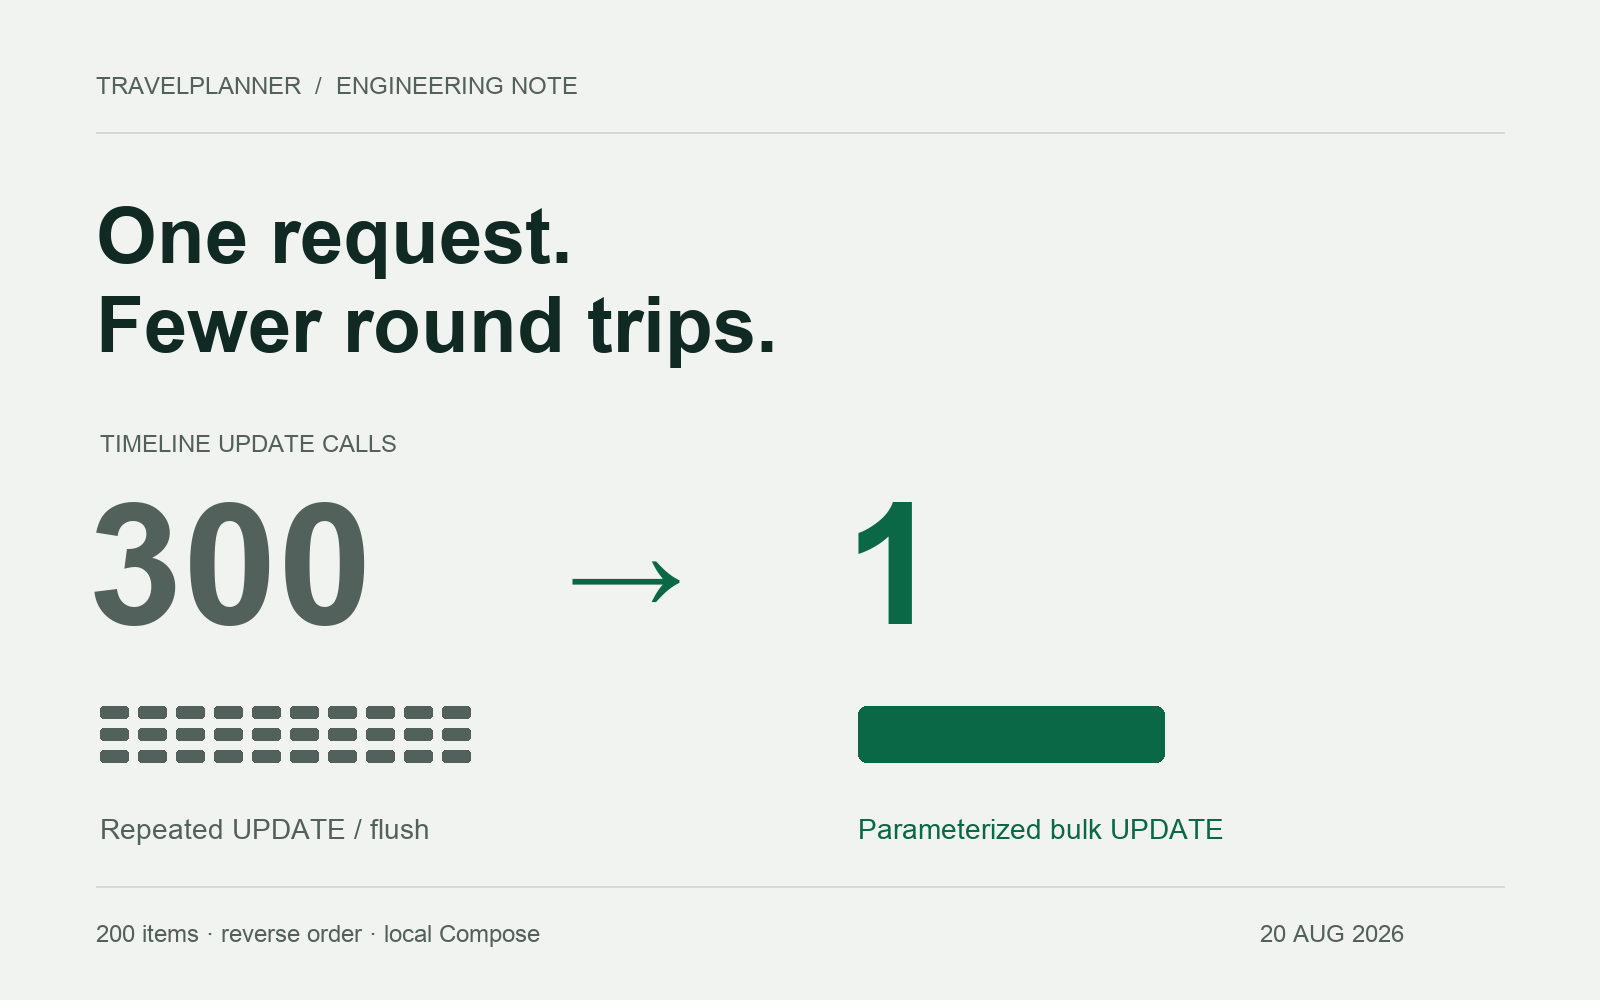
개별 timeline UPDATE의 PostgreSQL 평균 실행 시간 최대값은 0.098ms였습니다. 사전에 정한 5ms보다 훨씬 짧았습니다. 하지만 200개 항목의 reverse에서는 한 요청이 UPDATE를 300번 호출했습니다. 기존 서비스가 순서 변경 중 saveAndFlush를 반복하는 코드 경로와 일치했습니다.
이 관측은 해결할 위치를 바꿨습니다. 우선순위는 단일 UPDATE의 실행 계획을 추측하며 인덱스를 추가하는 일보다, 항목마다 발생하는 UPDATE·flush 왕복을 없애는 일이었습니다. 관측 stage에서 Hikari pending과 PostgreSQL deadlock은 0이었고, Redis failure나 health 이상도 없었습니다. 이번 재현에서는 순서 변경 경로의 호출 증폭이 가장 직접적인 설명이었습니다.
다만 PostgreSQL server execution time이 API 응답 시간 전부는 아닙니다. JDBC, 트랜잭션, 애플리케이션 처리와 네트워크 시간이 함께 들어갑니다. 그래서 DB 실행 시간과 API p95를 별도 지표로 유지했습니다.
순서 교환을 한 번에 쓰되, 정합성은 그대로 지킨다
순서 변경은 단순히 여러 행에 숫자를 쓰는 작업이 아닙니다. 같은 여행·같은 날짜에서 방문 순서는 중복될 수 없고, 두 요청이 동시에 순서를 바꿀 수도 있습니다. 성능을 위해 UPDATE만 합치면 이 계약을 깨뜨릴 수 있었습니다.
먼저 서비스가 여행 존재 여부와 쓰기 권한을 확인한 뒤, 해당 날짜의 현재 항목을 ORDER BY visit_order, id FOR UPDATE로 읽도록 했습니다. 같은 행을 바꾸는 동시 reorder가 row lock으로 직렬화되도록 하는 경로입니다. 요청 ID와 순서가 기존 항목의 올바른 순열인지 검증하고, 실제 mapping이 같으면 write를 생략합니다. noop은 요청 배열의 표현이 달라도 최종 순서가 같으면 UPDATE를 하지 않습니다.
실제 변경은 UUID 배열과 smallint 배열을 바인딩하는 한 번의 SQL로 처리합니다.
UPDATE timeline_table AS timeline_item
SET visit_order = requested.visit_order
FROM unnest(?::uuid[], ?::smallint[])
  AS requested(item_id, visit_order)
WHERE timeline_item.id = requested.item_id
  AND timeline_item.planner_id = ?
  AND timeline_item.day_number = ?
planner_id와 day_number 조건도 남겨 요청이 속한 범위 안에서만 변경합니다. SQL에 값을 이어 붙이는 대신 parameter binding을 사용하며, 변경 행 수가 요청 항목 수와 다르면 예외를 발생시켜 트랜잭션을 rollback합니다.
순서 교환 도중에는 기존 unique constraint가 중간 상태를 거부할 수 있습니다. V19 migration에서 (planner_id, day_number, visit_order) 제약을 DEFERRABLE INITIALLY IMMEDIATE로 재생성했습니다. 평소에는 즉시 검사하고, 순서를 바꾸는 트랜잭션에서만 제약 검사를 잠시 미룹니다. bulk UPDATE 직후 다시 IMMEDIATE로 돌려 최종 상태를 확인합니다.
따라서 “UPDATE 1회”는 모든 DB 왕복이 1회라는 뜻이 아닙니다. 잠금 조회와 제약 설정 등은 남습니다. 제거한 것은 항목 수에 따라 증폭되던 timeline UPDATE 호출입니다.
빨라진 것과 올바르게 바뀐 것을 따로 검증했다
서비스·repository·controller 테스트로 권한과 기존 HTTP 계약을 확인했습니다. repository integration test에는 동시 reorder, 예외 이후 원래 순서 복원, 지연한 제약의 최종 검사 실패와 rollback이 포함됐습니다. migration test에서는 기존 행 보존, 일반 중복 입력 거부, deferred swap 성공을 확인했습니다.
성능 판정도 실행 후에 정하지 않았습니다. baseline과 optimized의 profile digest, 실행 조합과 순서를 비교하고, 다음 조건을 미리 고정했습니다.
- noop UPDATE는 요청당 0회, reverse UPDATE는 1회여야 합니다.
- reverse에서 바뀐 행 수는 항목 수와 일치해야 합니다.
- 200개와 3개 항목의 총 SQL calls 비율은 1.25 이하여야 합니다.
- 200개 reverse API p95의 반복별 중앙값은 baseline의 70% 이하, DB execution/request 중앙값은 50% 이하여야 합니다.
- 항목 수 200 대 3의 reverse p95 비율은 세 반복 중 최소 두 번에서 2 이하여야 합니다.
최종 PR 검증 campaign은 36개 stage의 조합·순서·유효성을 모두 통과했습니다. noop 0회, reverse 1회와 행 수 검증도 통과했고 deadlock·오류가 없었습니다. p95 비율은 두 번째 반복에서 2.338로 기준을 넘었지만, 첫 번째 1.030과 세 번째 1.957이 통과해 사전에 정한 2/3 일치 규칙을 만족했습니다. 개별 반복의 미달을 지우고 전부 통과했다고 기록하지 않았습니다.
최종 PR 검증에서 남긴 숫자
아래는 최종 소스 1500d31294239f699923119a064b008300471800을 사용한 campaign의 결과입니다. 중간 최적화 실험의 더 낮은 지연 수치 대신, 최종 PR 검증 보고서의 값을 사용했습니다.
| 200개 항목 reverse | 변경 전 | 최종 PR 검증 |
|---|---|---|
| timeline UPDATE calls/request | 300 | 1 |
| API p95의 반복별 중앙값 | 83.106ms | 24.330ms |
| DB execution/request의 반복별 중앙값 | 13.325ms | 2.287ms |
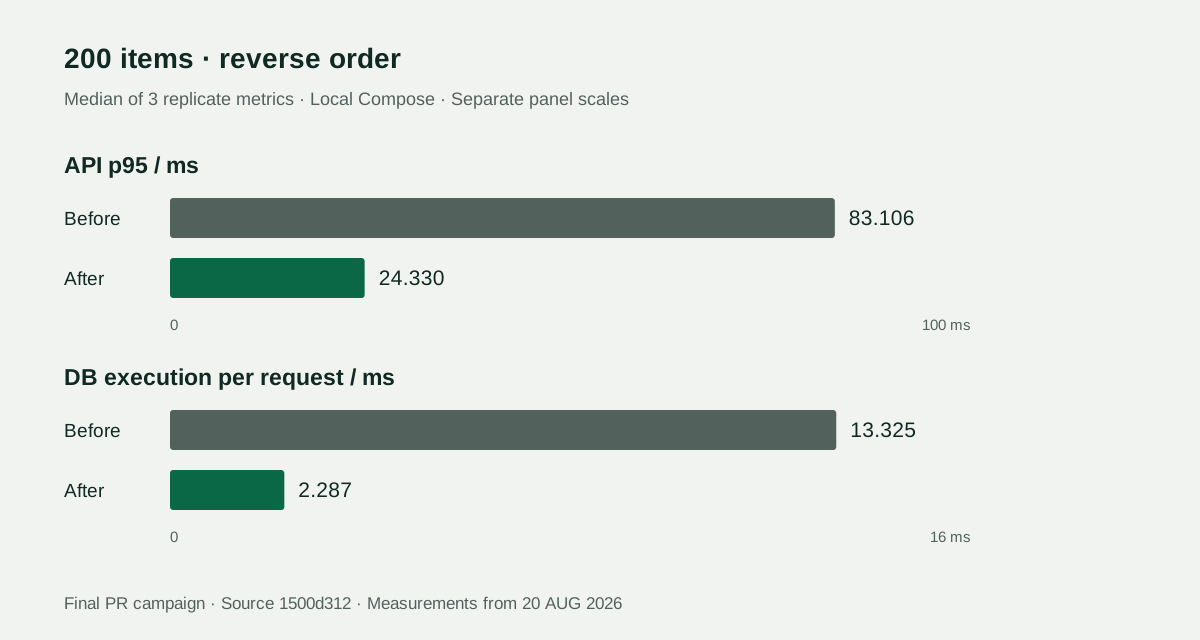
여기서 API p95 중앙값은 세 반복의 p95를 구한 뒤 그 중앙값을 취한 값입니다. 모든 요청을 한데 합쳐 계산한 p95와는 다릅니다. DB 값도 개별 SQL 한 번의 시간이 아니라 요청당 PostgreSQL 실행 시간을 집계한 지표입니다.
최종 판정은 confirmed-round-trip-reduction이었습니다. 항목 수에 비례하던 UPDATE 호출이 고정된 한 번으로 바뀌었고, 같은 프로필의 로컬 비교에서 API 지연과 요청당 DB 실행 시간도 함께 줄었습니다.
이 실험이 다음 판단에 남긴 것
이번 문제에서는 부하를 오래 유지하는 동안 부하 자체의 의미가 바뀌고 있었습니다. RPS만 보면 같은 시험이지만, 한 요청이 바꾸는 행 수는 계속 커졌습니다. CPU나 캐시부터 조정하기 전에 요청당 작업량을 고정하고, 호출 횟수와 한 호출의 비용을 나눈 것이 수정 방향을 정하는 데 도움이 됐습니다.
AWS에서 관찰한 현상이 질문의 출발점이었지만, 최적화 수치를 검증한 장소는 로컬 Compose입니다. 이 결과로 운영 RDS의 SLO나 EC2 ASG 처리량 개선을 주장하지 않습니다. V19를 운영에 적용할 때는 constraint 재생성의 잠금 시간, 동시 writer 정리, 배포 창과 migration rollback을 별도로 검토해야 합니다. 이번 실행은 production migration이나 배포를 수행하지 않았습니다.
개인 구현의 Git 근거는 공개된 protove 작성 PR #366입니다. 실험 로그 전체를 열지 않아도 숫자의 범위와 출처를 확인할 수 있도록 공개용 증거를 따로 정리했습니다.